अंकन निरीक्षण
कैमरा प्रिंटर या लेजर मार्कर के बाद स्थित है। engiAI प्रिंट की गई टेक्स्ट को सीधे वीडियो स्ट्रीम से पढ़ता है: यह टेक्स्ट को टुकड़ों में पढ़ता है, उन्हें एक उदाहरण या सूची से तुलना करता है, प्रत्येक मार्किंग को डेटाबेस में सहेजता है, और परिणाम को नेटवर्क पर भेजता है - ब्राउज़र, JSON और TCP कंट्रोलर के माध्यम से।
यह कैसे काम करता है
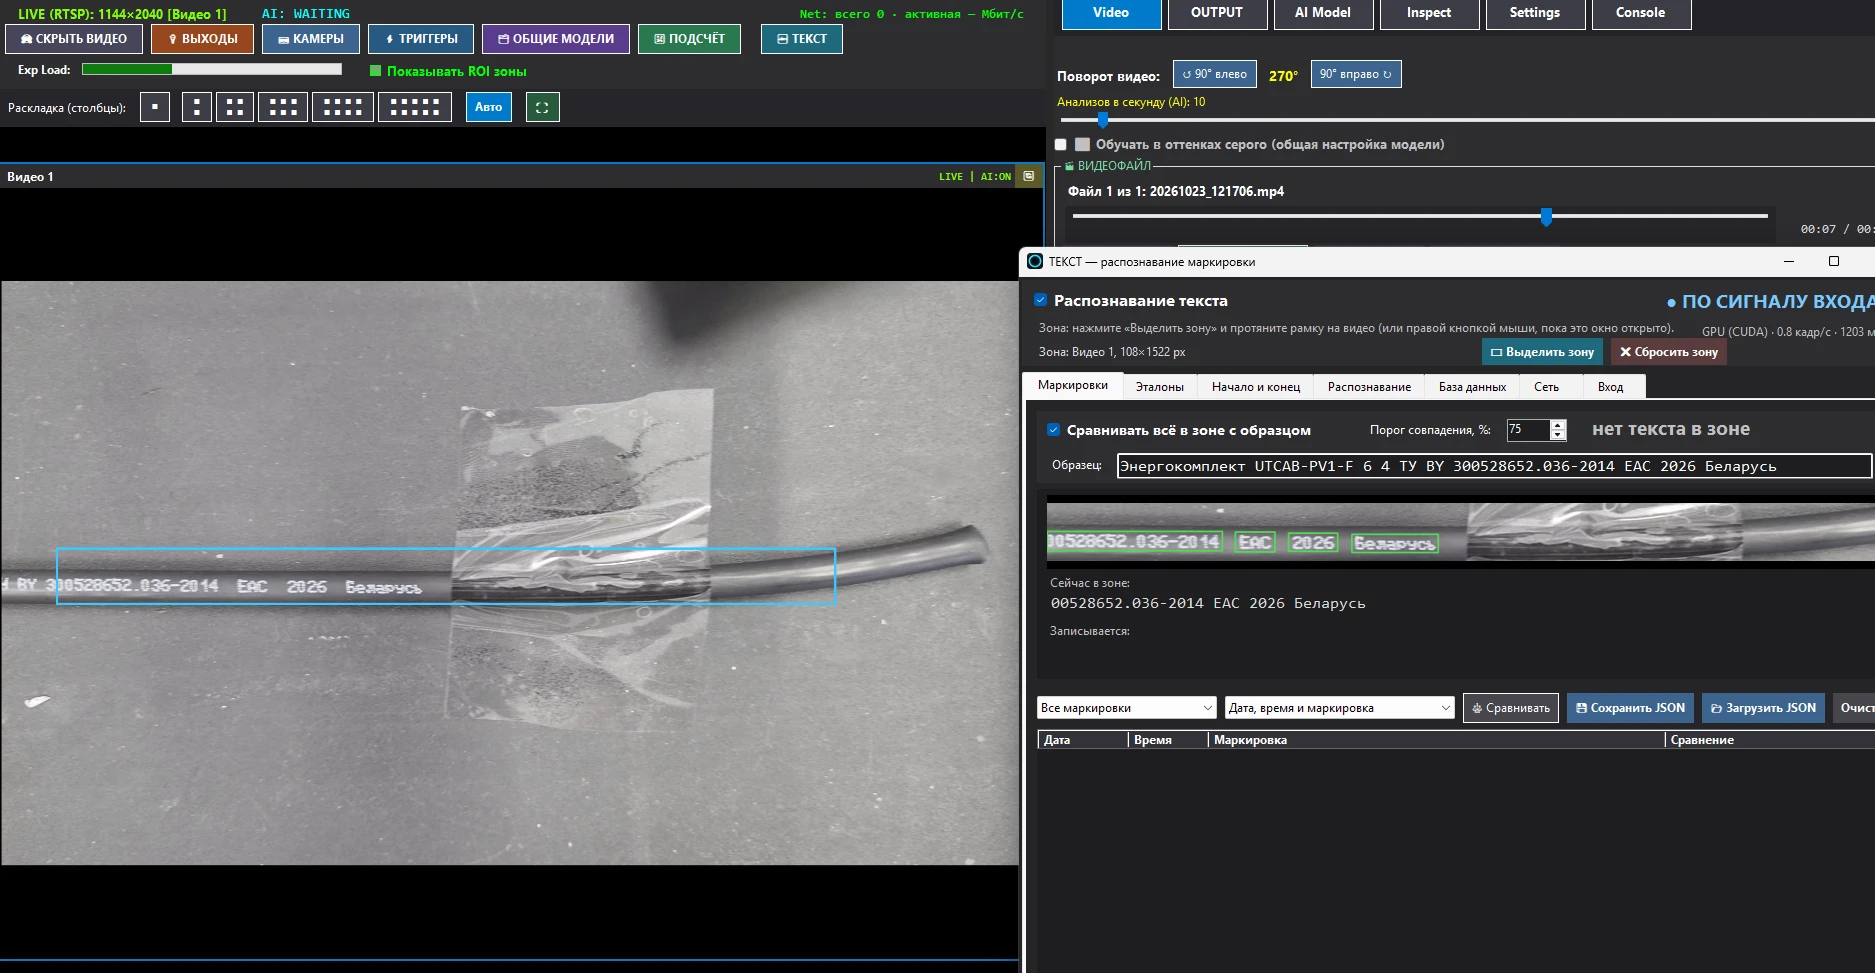
"टेक्स्ट” बटन मुख्य विंडो के ऊपरी पंक्ति में स्थित है, जो "engiAI" के बगल में है, और इसमें "बाहर", "कैमरा", "ट्रिगर", "सामान्य मॉडल" और "गणना" बटन शामिल हैं। यह "टेक्स्ट - मार्किंग पहचान" विंडो को खोलता है। विंडो को वीडियो के ऊपर खुला रखा जा सकता है: जब विंडो खुली होती है या पहचान चालू होती है, तो फ्रेम पर का क्षेत्र दिखाई देता है।
विंडो के शीर्ष पर तीन चीजें, जो सभी टैब के लिए सामान्य हैं:
- टेक्स्ट पहचान - यह मुख्य स्विच है। जब तक यह स्विच बंद रहता है, टेक्स्ट पहचान काम नहीं करती और यह प्रोग्राम पर कोई बोझ नहीं डालती।
- ▭ क्षेत्र को चिह्नित करें - वीडियो में किसी भी माउस बटन पर क्लिक करके और फ्रेम को खींचकर क्षेत्र को चिह्नित करें। जब विंडो खुली हो, तो आप बिना किसी बटन के माउस के दाहिने बटन का उपयोग करके फ्रेम को भी खींच सकते हैं। ✖ क्षेत्र को हटाएँ - यह क्षेत्र को हटा देता है।
- दाएं ओर स्थिति: मार्किंग की प्रतीक्षा, मार्किंग रिकॉर्ड, विराम या सिग्नल के अनुसार। इसके नीचे, यह दर्शाया गया है कि (GPU CUDA या प्रोसेसर) का उपयोग किया जा रहा है, प्रति सेकंड कितने फ्रेम पढ़े जा रहे हैं, और प्रत्येक फ्रेम के लिए कितने मिलीसेकंड लगते हैं।
"मार्किंग" टैब - परिणाम और नमूने के साथ तुलना
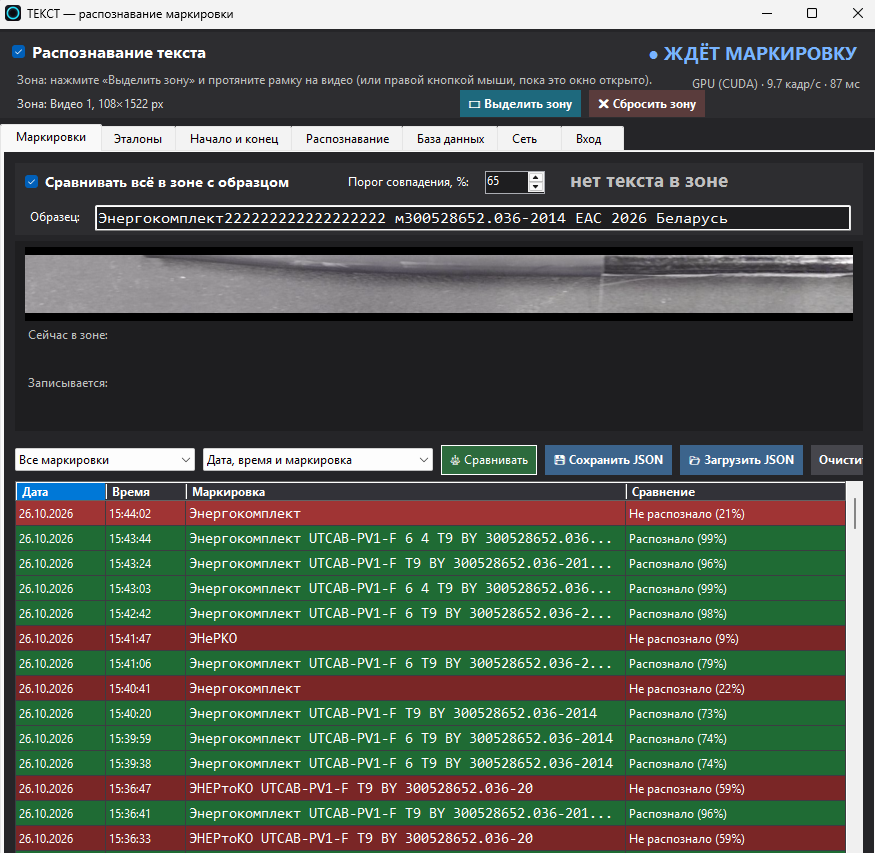
यह ऑपरेटर के लिए एक कार्यशील टैब है। ऊपर, "क्षेत्र में सभी चीज़ों की तुलना एक नमूने के साथ करें:"

कन्वेयर पर वाक्यांश का विश्लेषण कैसे होता है:
- रिकॉर्ड की शुरुआत वाक्य के पहले अक्षर से होती है। यदि रिकॉर्ड बीच में शुरू किया गया है, तो उसके अंत को अनदेखा कर दिया जाता है - प्रोग्राम अगले शुरुआती अक्षर का इंतजार करता है।
- प्रत्येक फ्रेम को एक नमूने में सही स्थान पर रखा जाता है, और प्रत्येक अक्षर को सभी उन फ्रेमों से "वोट" मिलते हैं जिनमें वह दिखाई देता है। अंत में, वह विकल्प चुना जाता है जिसे सबसे अधिक बार पढ़ा गया है। किसी एक फ्रेम में होने वाली मामूली त्रुटियों (जैसे, किनारे से कटा हुआ अक्षर या चमक) को आस-पास के फ्रेमों द्वारा ठीक किया जाता है। धीमी गति से काम करने पर, अधिक फ्रेमों के वोट शामिल होते हैं, जिससे परिणाम अधिक सटीक होता है।
- "परिणाम प्रदर्शित किया जाता है, जैसे ही वाक्यांश पूरी तरह से प्रसंस्करण क्षेत्र से गुजर जाता है, या यदि "पहचान" टैब में निर्दिष्ट समय से अधिक समय तक कोई नया अक्षर नहीं आता है (यानी, प्रसंस्करण रुक गया है और क्षेत्र खाली है)। परिणाम प्रदर्शित होने के बाद, प्रोग्राम अगले वाक्यांश की शुरुआत का इंतजार करता है; लगातार आने वाले वाक्यांशों को प्रत्येक को अलग-अलग रिकॉर्ड किया जाता है।"
- प्रोग्राम स्वयं निर्धारित करता है कि वाक्यांश कैसे चलना है या "टेक्स्ट कहाँ से आता है" सेटिंग से लेता है।
जब वाक्यांश चल रहा होता है, तो दरवाजे के दाहिने तरफ, आप 40 में से 64 अक्षरों को देख सकते हैं, और "रिकॉर्ड किया जा रहा है" पंक्ति में, मिलान और एकत्र किए गए पाठ का प्रतिशत दर्शाया जाता है। परिणाम के बाद, 73% - पहचान या पहचान नहीं दिखाई देता है। यही परिणाम वीडियो के ऊपर बड़े अक्षरों में भी प्रदर्शित होता है।
जब "नमूने के क्षेत्र में सब कुछ तुलना करें" विकल्प को चेक नहीं किया जाता, तो अनुक्रमिक रूप से एक-एक करके लिखा जाता है: प्रत्येक वाक्यांश को "शुरुआत और अंत" टैब के नियमों के अनुसार शुरुआत से अंत तक लिखा जाता है, और यदि आवश्यक हो, तो संदर्भ सूची के साथ तुलना की जाती है।
सूची के नीचे - नियंत्रण:
- सभी मार्किंग / केवल अंतिम - यहाँ प्रदर्शित करने और ब्राउज़र को भेजने के लिए, यह कितने मार्किंग को दर्शाएगा।
- तारीख, समय और मार्किंग / केवल मार्किंग - ब्राउज़र को क्या भेजना है और इसे JSON में कैसे सहेजना है।
- ⚖ तुलना करना — प्रत्येक तैयार किए गए मार्किंग की, चिह्नित संदर्भों से तुलना करना।
- 💾 JSON को सहेजें, 📂 JSON को डाउनलोड करें (डाउनलोड किए गए मार्किंग संदर्भ के रूप में उपयोग किए जाते हैं), सूची साफ़ करें — स्क्रीन और ब्राउज़र से पंक्तियों को हटा देता है, लेकिन डेटाबेस में वे बने रहते हैं।
"संदर्भ" टैब - सही मिलान की सूची
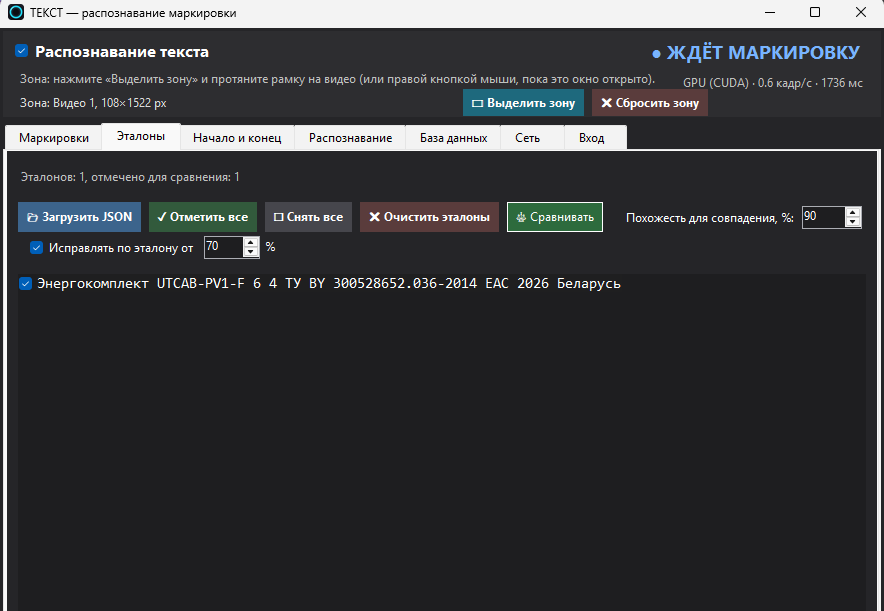
संदर्भ तब उपयोगी होते हैं जब लाइन पर कई अलग-अलग मिलान होते हैं (विभिन्न खंड, बैच, ग्राहक), और प्रत्येक को सूची में खोजना होता है।
- 📂 JSON फ़ाइल से डाउनलोड करें — फ़ाइल से प्राप्त सूची: हमारी JSON, स्ट्रिंग की एक सरणी, टेक्स्ट फ़ील्ड वाली वस्तुएं, या स्ट्रिंग पर मार्किंग के साथ केवल टेक्स्ट। डुप्लिकेट हटा दिए गए हैं।
- ✓ सभी को चिह्नित करें, ☐ सभी को हटा दें, प्रत्येक पंक्ति पर टिक - किसके संदर्भों की तुलना करनी है। ✖ संदर्भों को हटाएं - सूची को हटा दें।
- मिलान के लिए समानता, % - 100 का मतलब है कि अक्षर अक्षर मिल रहे हैं (बिना रिक्त स्थान और केस की परवाह किए)। नीचे, टाइपिंग और पढ़ने की त्रुटियों की अनुमति है।
- मानक के अनुसार सुधार: ... % - यदि पढ़ी गई सामग्री, चिह्नित संदर्भ के समान है, तो मानक के पाठ के साथ चिह्नित किया जाता है (मूल पाठ लॉग में रहता है)।
"शुरुआत और अंत" टैब - एक मिलान कहाँ समाप्त होता है
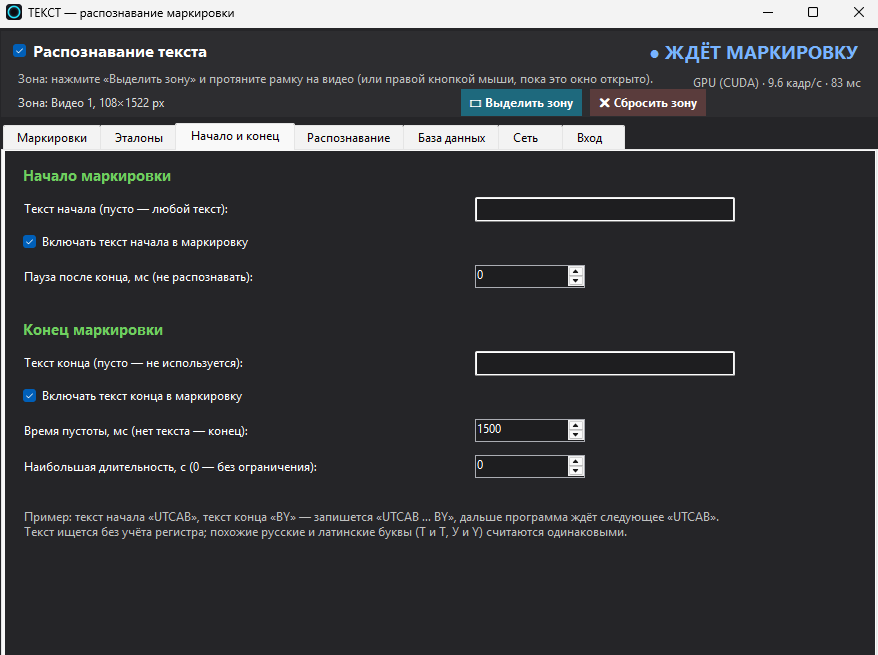
ये नियम क्रमिक संयोजन (बिना उदाहरण के) मोड में काम करते हैं, जब प्रोग्राम स्वयं तय करता है कि मार्किंग कहाँ शुरू और समाप्त होती है:
- पाठ की शुरुआत — यह रिकॉर्ड तब शुरू होता है जब इस पाठ को क्षेत्र में पढ़ा जाता है (उदाहरण के लिए UTCAB)। खाली - किसी भी पाठ के लिए। यदि पाठ एक चक्र में चलता है, तो पाठ की दूसरी उपस्थिति को चिह्नित करना समाप्त कर देता है। पाठ की शुरुआत को चिह्नित करना - इसे परिणाम में शामिल करना।
- मार्किंग के अंत के बाद, मिलीसेकंड में - तैयार मार्किंग के बाद, कुछ भी दर्ज नहीं करना चाहिए।
- अंत का पाठ - यह पाठ पढ़ने पर, मार्किंग समाप्त हो जाती है (उदाहरण के लिए BY या 2026)।
- खाली समय, मिलीसेकंड - यदि क्षेत्र में कोई टेक्स्ट नहीं है, तो मार्किंग समाप्त हो जाती है और इसे सहेज लिया जाता है।
- अधिकतम अवधि, यानी — लगातार लेखन के लिए, बिना किसी अंतराल के: प्रत्येक अंतराल के बाद एक अलग मार्किंग। 0 का मतलब है कि कोई सीमा नहीं है।
उदाहरण: "UTCAB" की शुरुआत, "BY" की अंत - "UTCAB … BY" लिखा जाएगा, इसके बाद प्रोग्राम "UTCAB" की प्रतीक्षा करता है। केस को ध्यान में न रखते हुए, समान रूसी और लैटिन अक्षर समान माने जाते हैं।
"पहचान" टैब - क्षेत्र, मोड़, मॉडल
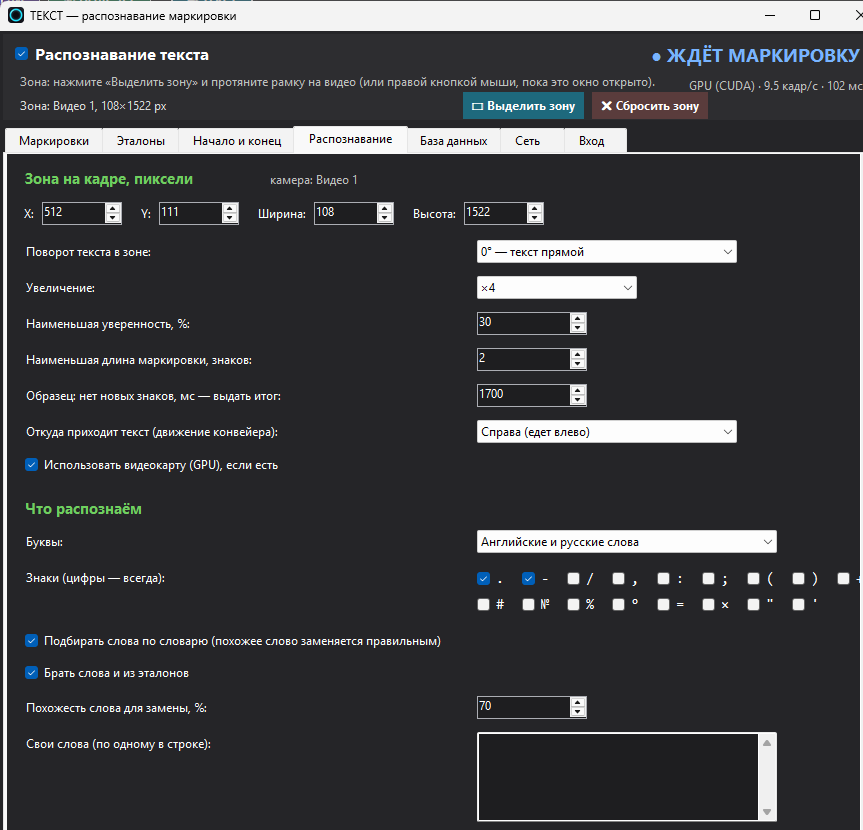
- फ्रेम में क्षेत्र, पिक्सेल - X, Y, मूल फ्रेम में क्षेत्र की चौड़ाई और ऊंचाई: फ्रेम को सटीक रूप से समायोजित करना, बिना माउस का उपयोग किए।
- टेक्स्ट को क्षेत्र में घुमाना - क्षेत्र को इस तरह घुमाएं कि टेक्स्ट सीधा हो जाए। टेक्स्ट ऊपर से नीचे की ओर जाता है - "90° घड़ी की विपरीत दिशा में", नीचे से ऊपर की ओर - "90° घड़ी की दिशा में"। स्क्रीन पर वीडियो को घुमाने के लिए, "वीडियो" टैब पर "वीडियो घुमाएं" विकल्प का उपयोग करें।
- बढ़ाने - यदि आप टेक्स्ट के क्षेत्र को बढ़ाते हैं, तो यह छोटा टेक्स्ट पढ़ने में बेहतर होगा; "ऑटो" स्वचालित रूप से इसे समायोजित कर देगा।
- सबसे कम आत्मविश्वास, % - जिन शब्दों को कम आत्मविश्वास के साथ पढ़ा गया है, उन्हें हटा दिया जाता है (जैसे कि अक्षरों के किनारों या किनारों)।
- सबसे छोटा मार्किंग की लंबाई, संकेतों की लंबाई - यदि परिणाम बहुत छोटे हैं, तो वे संरक्षित नहीं होते।
- नमूना: कोई नई जानकारी नहीं, एमएस - परिणाम जारी करना - यदि नमूने में कोई नई जानकारी नहीं मिलती है (जैसे कि कन्वेयर बंद हो गया है, क्षेत्र खाली है, या टेक्स्ट पढ़ने योग्य नहीं है), तो परिणाम कब तक इंतजार करना है? एक बार परिणाम प्राप्त होने के बाद, एक नई विश्लेषण शुरू होती है।
- टेक्स्ट कहाँ से आती है - यह बताता है कि टेक्स्ट किस दिशा से क्षेत्र में आता है। "ऑटो" तस्वीरों के आधार पर यह निर्धारित करता है, और "स्प्लिस" का उपयोग करना अधिक विश्वसनीय है।
- ग्राफिक्स कार्ड (GPU) का उपयोग करना: NVIDIA के साथ, जो CUDA तकनीक का उपयोग करता है, डेटा पढ़ने की गति कई गुना बढ़ जाती है।
- अक्षर और चिह्न - लेबल में क्या हो सकते हैं: अंग्रेजी और रूसी शब्द, केवल अंग्रेजी शब्द या कोई भी चिह्न; संख्याएँ और रिक्त स्थान - हमेशा, चिह्नों (बिंदु, डैश, तिरछी रेखा, # आदि) को चेक के साथ दर्शाया जाता है। मॉडल केवल स्वीकृत चिह्नों में से एक का चयन करता है - अनावश्यक चिह्न नहीं दिखाई देते, और समान चिह्न को सटीक रूप से पहचाना जाता है।
- शब्दों का चयन - शब्दकोश से - पहचाना गया शब्द (3 अक्षरों या अधिक, संख्या या कोड नहीं), जो शब्दकोश में मौजूद शब्द के समान है (न्यूनतम एक निश्चित प्रतिशत), उसे सही शब्द से बदल दिया जाता है। शब्दकोश में अपने शब्द (एक पंक्ति में एक शब्द) और, यदि चेक किया गया है, तो संदर्भ से शब्द शामिल हैं।
इस टैब के नीचे, आप मॉडल चुन सकते हैं: पंक्तियों की खोज (v3 - तेज़, v5 सर्वर - वीडियो कार्ड के लिए अधिक सटीक) और पाठ पढ़ना (सिरिलिक, लैटिन और संख्याएँ; केवल लैटिन और संख्याएँ; यूरोपीय भाषाओं के लैटिन; सटीक सर्वर मॉडल; या दो मॉडल एक साथ - दोनों पंक्तियों को पढ़ते हैं, अधिक विश्वसनीय विकल्प चुना जाता है)। गायब मॉडल को ⬇ डाउनलोड बटन के माध्यम से डाउनलोड किया जा सकता है। ⚖ वर्तमान क्षेत्र में मॉडलों की तुलना करें बटन सभी विकल्पों के माध्यम से नवीनतम क्षेत्र के स्निपेट को चलाता है - इससे तुरंत पता चलता है कि कौन सा मॉडल आपके विशिष्ट मार्किंग को सबसे अच्छी तरह से पढ़ता है और इसमें कितने मिलीसेकंड लगते हैं।
"डेटाबेस" टैब - सभी मार्किंग संग्रहीत हैं
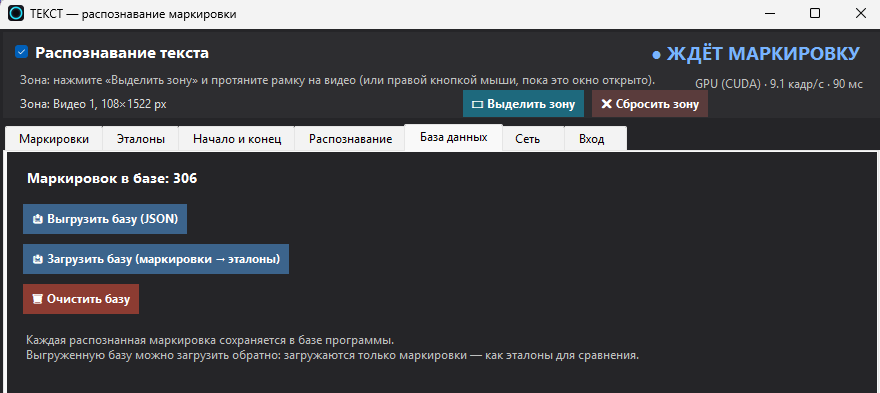
स्क्रीन पर दिखाई देने वाली सूची के बावजूद, प्रत्येक पहचाने गए मार्किंग को कार्यक्रम के डेटाबेस में दिनांक, समय, कैमरे, टेक्स्ट और तुलना के परिणाम के साथ संग्रहीत किया जाता है।
- 📤 डेटाबेस को निर्यात करें (JSON) - सभी जानकारी को फ़ाइल में सहेजें ताकि रिपोर्ट तैयार की जा सके या इसे अकाउंटिंग सिस्टम में भेजा जा सके।
- 📥 डेटाबेस डाउनलोड करें (मार्किंग → संदर्भ) - केवल मार्किंग वाले टेक्स्ट डाउनलोड किए जाते हैं, जो संदर्भ बन जाते हैं। इस प्रकार सत्यापित परिवर्तन का उपयोग बाद के उदाहरणों के लिए किया जा सकता है।
- 🗑 डेटाबेस साफ़ करें - सभी प्रविष्टियों को हटा दें।
"नेटवर्क" टैब - ब्राउज़र और JSON में परिणाम
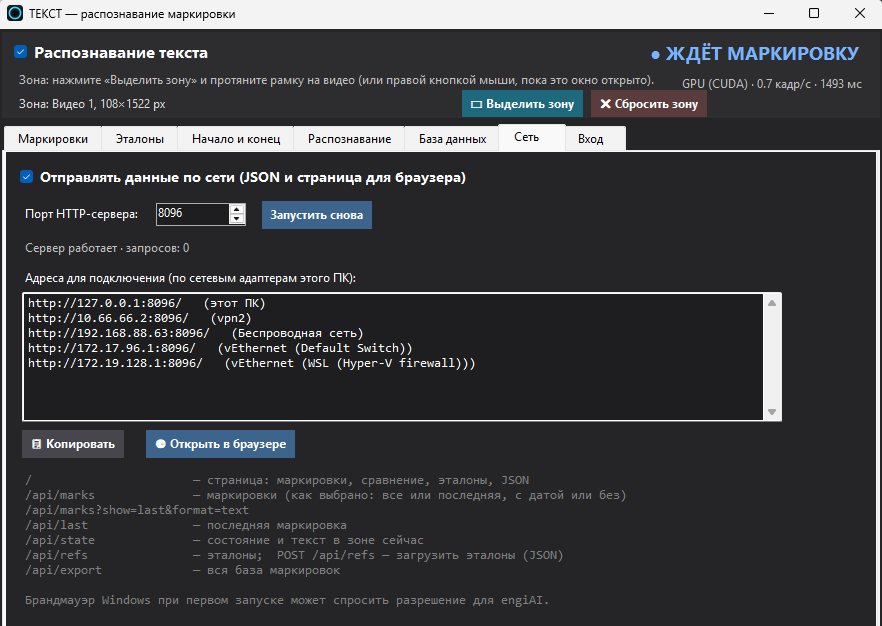
नेट पर डेटा भेजने को चिह्नित करें — engiAI एक HTTP सर्वर शुरू करेगा (डिफ़ॉल्ट पोर्ट 8096)। नेटवर्क में मौजूद कोई भी कंप्यूटर या टैबलेट, सामान्य ब्राउज़र में मार्किंग, तुलना और संदर्भ के साथ पेज खोलता है; कुछ भी इंस्टॉल करने की आवश्यकता नहीं है। 📋 कॉपी करें और 🌐 ब्राउज़र में खोलें बटन सूची से पता प्राप्त करते हैं।
| पता | क्या दिया जा रहा है |
|---|---|
| / | पृष्ठ: मार्किंग, तुलना, संदर्भ, JSON |
| /api/marks | मार्किंग - सभी या अंतिम, दिनांक के साथ या बिना (जैसा कि विंडो में चुना गया है) |
| /api/marks?show=last&format=text | अंतिम मार्किंग सरल टेक्स्ट में |
| /api/last | अंतिम मार्किंग |
| /api/state | वर्तमान में क्षेत्र में स्थिति और टेक्स्ट |
| /api/refs | संदर्भ: POST /api/refs — संदर्भ (JSON) डेटा अपलोड करें |
| /api/export | सभी मार्किंग का डेटाबेस |
जब पहली बार विंडोज शुरू किया जाता है, तो फ़ायरवॉल आपसे engiAI तक पहुँच के लिए अनुमति मांगने की आवश्यकता हो सकती है - उन नेटवर्क में पहुँच की अनुमति दें जहाँ आपको इसकी आवश्यकता है।
"इनपुट" टैब - कंट्रोलर सिग्नल के अनुसार छवि
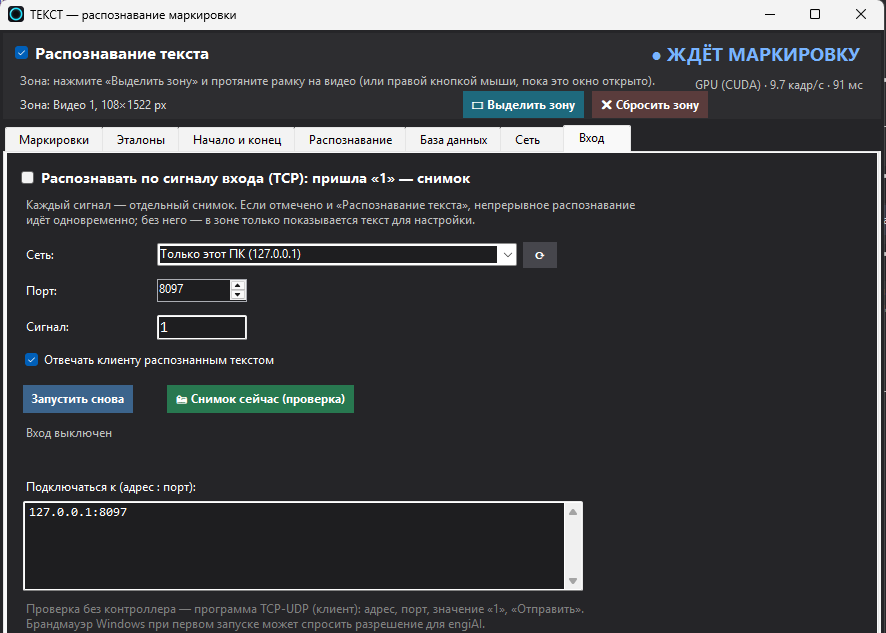
जब उत्पाद कैमरे के सामने सिग्नल के माध्यम से आता है (जैसे कि सेंसर, पीएलसी, या रोबोट), तो "इनपुट सिग्नल के आधार पर पहचान (TCP)" विकल्प को सक्षम करें। "engiAI" TCP सर्वर को खोलता है; प्रत्येक सिग्नल एक क्षेत्र की तस्वीर होती है: टेक्स्ट को पहचाना जाता है, तुलना की जाती है और लगातार मोड की तरह, डेटाबेस में संग्रहीत किया जाता है।
- नेटवर्क - किस नेटवर्क एडाप्टर पर सिग्नल की उम्मीद करनी है («सभी नेटवर्क» - किसी भी पर); आप मैन्युअल रूप से IP दर्ज कर सकते हैं। पोर्ट - डिफ़ॉल्ट रूप से 8097।
- सिग्नल - इसे किस चीज़ को कमांड माना जाएगा। डिफ़ॉल्ट रूप से 1: टेक्स्ट ("1", "1\r\n") या बाइट 0x01।
- ग्राहक को पहचाने गए टेक्स्ट के साथ प्रतिक्रिया देना - प्रतिक्रिया में एक मार्किंग वाला स्ट्रिंग आता है, जब तुलना की जाती है, तो यह या तो ओके या एनजी होता है, जो टैब द्वारा अलग किए जाते हैं; कोई टेक्स्ट नहीं - टेक्स्ट नहीं मिला, त्रुटि… - कोई क्षेत्र या फ्रेम नहीं।
- 📸 वर्तमान में ली गई तस्वीर (जांच) - यह एक सिग्नल की तरह है, लेकिन यह बटन से भेजा जाता है। बिना कंट्रोलर के, इसे TCP-UDP (क्लाइंट) प्रोग्राम का उपयोग करके जांचा जा सकता है: पता, पोर्ट, "1" और "भेजें" का मान।
इनपुट और निरंतर पहचान एक साथ काम करते हैं: यदि "टेक्स्ट पहचान" चिह्नित है, तो प्रोग्राम कन्वेयर पर नज़र रखता है, और प्रत्येक सिग्नल के लिए अतिरिक्त रूप से स्नैप लेता है।
